转换
改容器、编码或分辨率。只换容器且目标支持源编码时,直接封装不重新编码;文件夹批量会自动跳过已存在的输出。
mkv / mp4 / mov / avi / ts / flv / webm / wmv
Avoxkit · Windows / macOS · v0.2.0
Avoxkit 是一个免费的桌面音视频工具箱:转换格式、截取片段、提取音频与字幕、去掉图片水印。文件只在这台电脑上处理,不上传;不用登录,没有会员,产物也不带水印。

所有功能免费,没有会员等级,不在产物上加水印。
媒体文件只在这台电脑上处理,不会上传到任何服务器。
不需要注册、登录,也不收集使用数据。
Features
Avoxkit 面向常规音视频处理:把这个文件处理成我要的样子。它不是剪辑软件,不做多轨时间线。
改容器、编码或分辨率。只换容器且目标支持源编码时,直接封装不重新编码;文件夹批量会自动跳过已存在的输出。
mkv / mp4 / mov / avi / ts / flv / webm / wmv
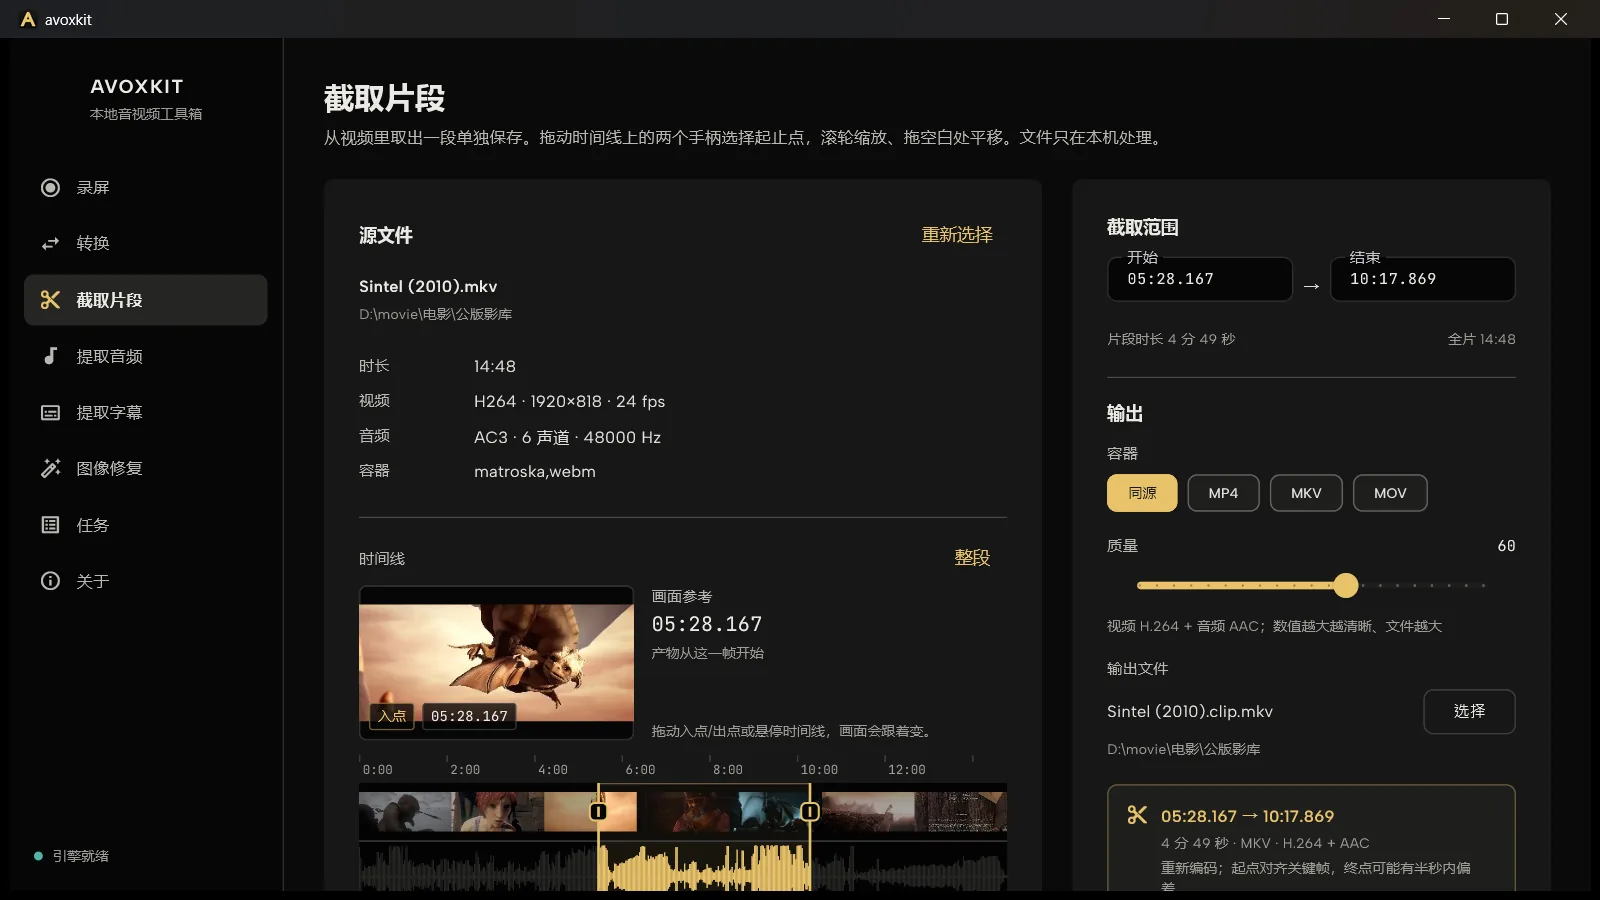
在缩略图、波形与关键帧时间线上选起止点,保存其中一段。起点吸附到关键帧,界面上显示的时间就是产物的真实起点。
片段重新编码,不是无损剪切
从视频导出 M4A 或 MP3,也可以原样导出原始音轨,不重新编码,速度最快。
M4A / MP3 可文件夹批量 · 128–320 kbps
内嵌文本字幕轨直接导出 SRT;没有文本轨时用本地语音识别生成,识别在本机完成。
中 / 英 / 日 / 韩 / 粤 · 模型约 230 MB 按需下载
自动识别或手动涂抹,去掉图片里的水印、台标和叠加文字,由模型补全背景。
LaMa + YOLO26-Seg · 模型约 290 MB 按需下载
统一队列、进度与取消;批量组可整组取消,失败项一键重试。处理中可以看到正在处理的画面或音频包络。
先写临时文件,成功后才替换最终文件
Trim
时间线上铺着整片的缩略图条,有音轨就画包络,关键帧用短刻度标出。拖动两个手柄选区间,起点自动吸附到目标前最近的关键帧。
它不是播放器:没有播放头,也不做逐帧预览,只负责把起止点选准。
Repair
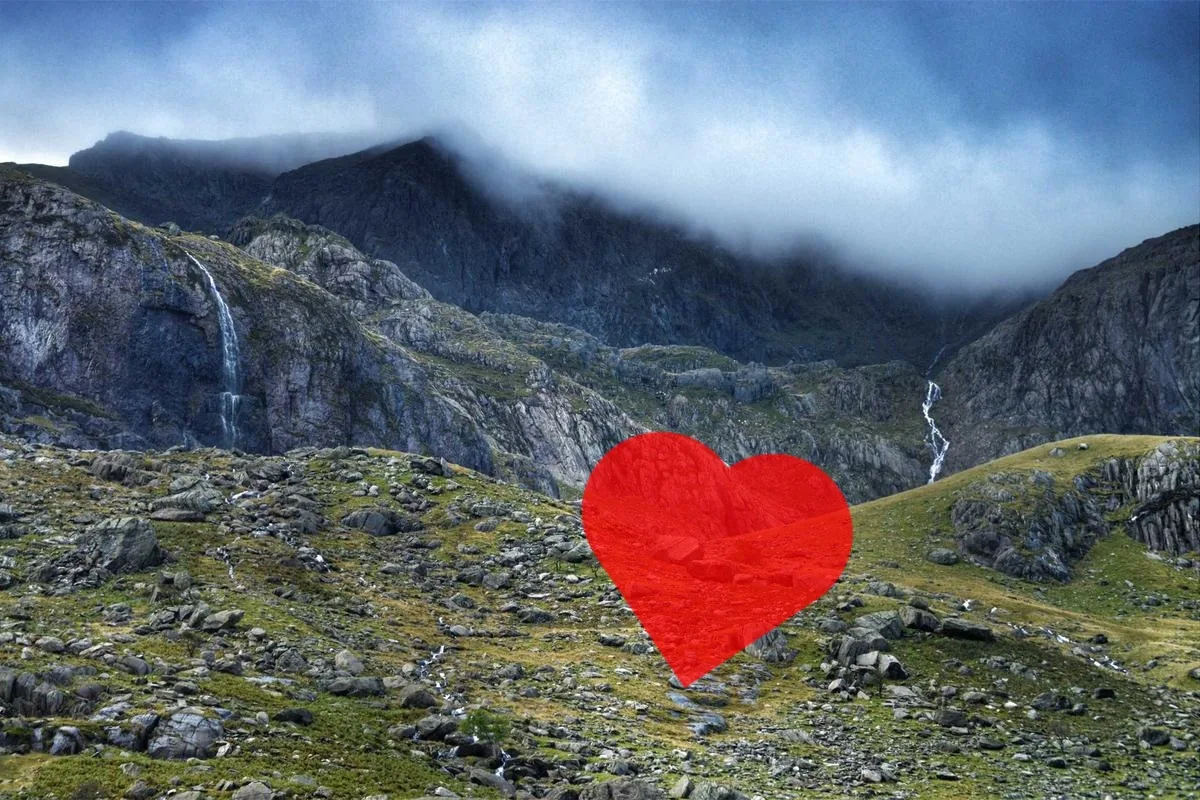
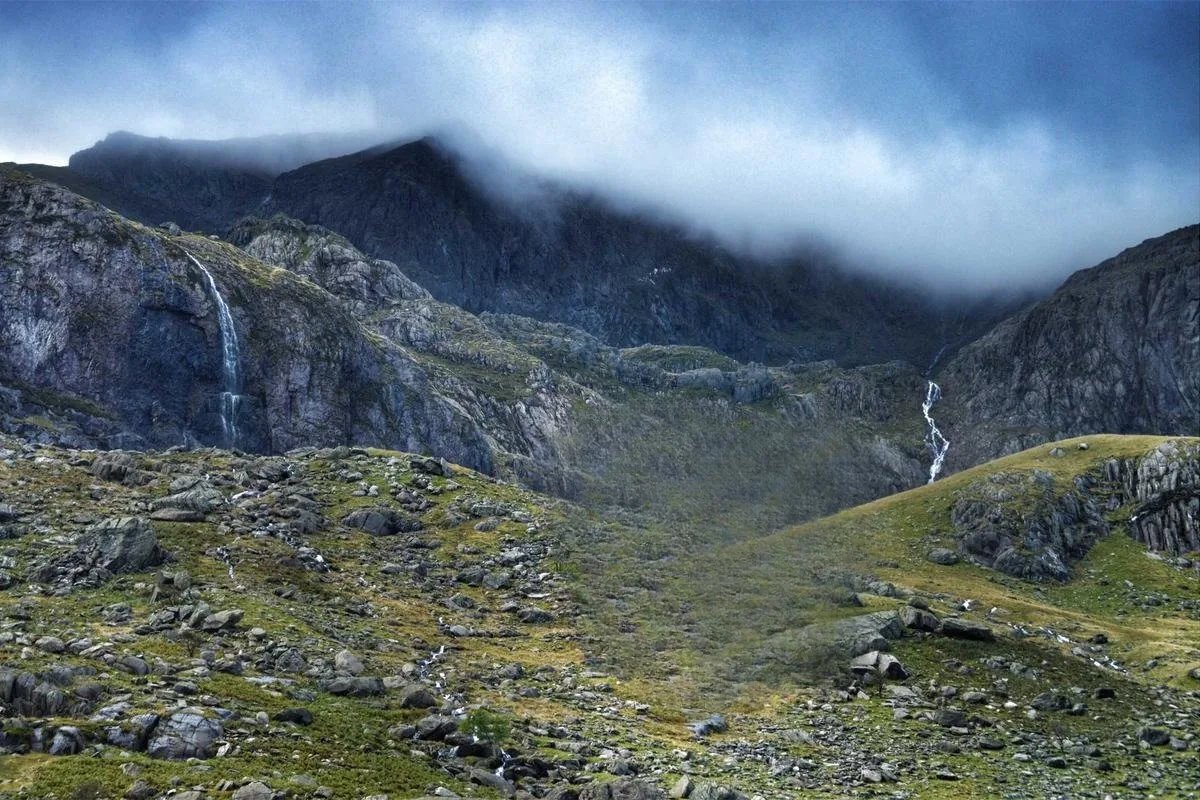
自动模式先在本机识别可疑水印位置,再补全背景;手动模式在预览图上涂抹,只修涂过的区域。整个文件夹批量时统一走自动识别。
修复是生成式补全,不保证与原背景完全一致;重要的图片建议保留原图。
Limits
截取不是无损剪切。片段按 H.264/H.265 加 AAC 重新编码;终点按时间截断,可能有半秒内偏差。
直接封装不等于瞬间完成。仍然要完整读写文件,云盘与机械盘会受磁盘速度限制。
识别与修复的模型按需下载。语音识别约 230 MB,图像修复约 290 MB,带 SHA-256 校验,不用不下载。
不做多轨剪辑。没有时间线工程、轨道与特效;需要剪辑创作时,请用专门的编辑软件。
Get
当前版本 0.2.0,Windows 64 位与 macOS(Apple Silicon)桌面版,还在活跃开发。
从源码构建:仓库在 github.com/xxxzhou/avoxkit,原生层按 native/avtool/README.md 构建,Windows 打包跑 script/build_windows.ps1,产物是一个免安装目录。
界面用 Flutter 构建,媒体处理由开源引擎 avox 完成;语音识别用 sherpa-onnx(SenseVoice),图像修复用 LaMa 与 YOLO26-Seg。项目以开源许可发布,源码在 GitHub。
不会。所有媒体处理都在本机完成,应用没有遥测、云同步或自动上传逻辑;也不需要账号,不收集使用数据。
转换、截取与提取都不需要联网。首次使用语音识别或图像修复时按需下载模型(约 230 MB 与 290 MB),下载只获取模型文件,不读取你的媒体文件。
当前提供 Windows 64 位与 macOS(Apple Silicon)桌面版。转换支持 mkv、mp4、mov、avi、ts、flv、webm、wmv 等常见容器。
Windows 版目前没有做代码签名,首次运行可能弹出 SmartScreen 提示:点「更多信息」,再点「仍要运行」。这是未签名独立软件的常见情况,下载的文件可用 Release 附带的 SHA-256 校验。macOS 版已做 Developer ID 签名与公证,正常打开不会被拦。
文件不出本机:没有大小与数量限制,不用排队上传下载,整个文件夹可以一次批量处理。对包含私人内容的视频,这一点尤其重要。
Avoxkit 面向常规处理:转换、截取、提取。没有多轨时间线与特效,需要剪辑创作时请用专门的编辑软件。
可以。只换容器、且目标容器支持源编码时直接封装,不重新编码;目标编码不同才会转码。整个文件夹可以一次批量处理,已存在的输出会自动跳过。
能。内嵌没有文本轨时在本机跑语音识别(中、英、日、韩、粤),输出标准 SRT;识别模型约 230 MB,首次使用时下载。