提取内嵌字幕
大多数片源带内嵌文本字幕轨。选「提取字幕」,直接得到一条 SRT,内容就是轨里的原文,几秒出结果,全程不联网。
SRT · 不联网 · 原文直出
Avoxkit · 字幕 · 本地语音识别
视频里已有内嵌字幕轨,直接导出 SRT;没有文本轨,就在本机跑语音识别生成。文件不上传,不排队,也不收会员。

Two paths
Avoxkit 的字幕功能有两条路,按素材里有没有现成的文本轨自动选择。
大多数片源带内嵌文本字幕轨。选「提取字幕」,直接得到一条 SRT,内容就是轨里的原文,几秒出结果,全程不联网。
SRT · 不联网 · 原文直出
没有文本轨的素材——手机录像、录屏、口述录音——走本地语音识别,中、英、日、韩、粤。识别在本机完成,首次使用时下载识别模型(约 230 MB,带 SHA-256 校验),之后离线可用。
SenseVoice · 单文件与文件夹批量
Batch
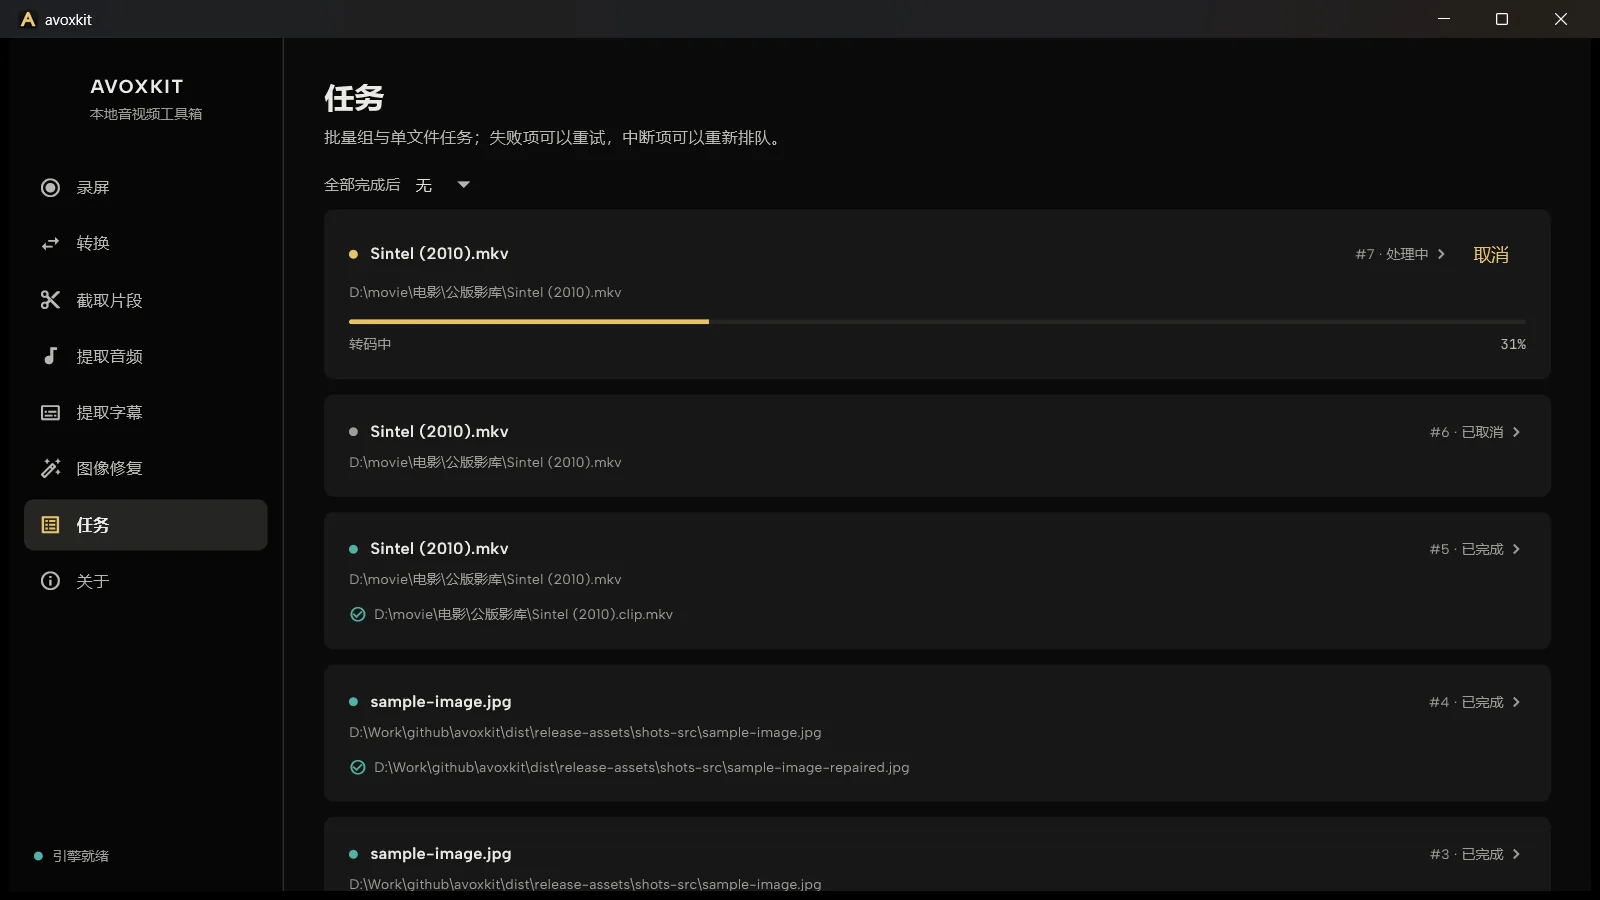
整个文件夹拖进来,统一排队、统一进度,失败项一键重试。跑批时能看到正在处理的画面与音频包络,识别到哪一段一眼可见。
先写临时文件,全部成功后才替换最终文件。
Limits
识别不是逐字稿。专有名词、同音字可能出错,对外发布的字幕建议过一遍人工校对。
识别耗时按机器算。长视频在本机跑需要时间,速度取决于 CPU 与内存,不是云端那种几分钟出片。
准确率视音质而定。口音、背景噪声、多说话人都会影响结果;普通话与英语最稳。
模型按需下载。约 230 MB,只下模型文件,不读你的媒体文件,不用不下载。
Get
当前版本 0.2.0,Windows 64 位与 macOS(Apple Silicon),完全免费。
下载:GitHub Releases,或看Avoxkit 主页。
不会。字幕提取与语音识别都在本机完成,应用没有遥测或自动上传逻辑,也不需要账号。
语音识别支持中、英、日、韩、粤。内嵌字幕轨的提取与语言无关,轨里是什么就导出什么。
取决于机器配置,普通家用电脑通常几分钟量级;批量时在队列里排队自动跑。
输出标准 SRT,任何文本编辑器都能改。要转 ASS/VTT 或整体调时间轴,用影音工具箱里的免费小工具即可。