音频的节拍与进度由设备决定
视频有帧率,播放器按 PTS 算出每一帧该在什么时刻出现,在渲染这一段上它自己就是节拍器。音频没有这个东西。采样是连续的,一段数据放多久由采样率和字节数决定,什么时候从扬声器出来由设备决定,播放器在这条链上的动作只剩一件事:把数据按时递过去。
递的粒度是定长的。连续的采样被切成一段一段,长度按一帧算(按时间算的一帧,与视频那种画面帧是两回事);一段的字节数由采样率、采样格式与声道数一起算出来。这个长度是后面所有缓冲的度量单位——设备缓冲要多大、还积着多少,都拿它当尺子。
对视频来说,播到哪一帧自己心里有数;音频这个数在设备手里,而设备只肯告诉你它手上还积着多少没放完。
两条线程、两级队列
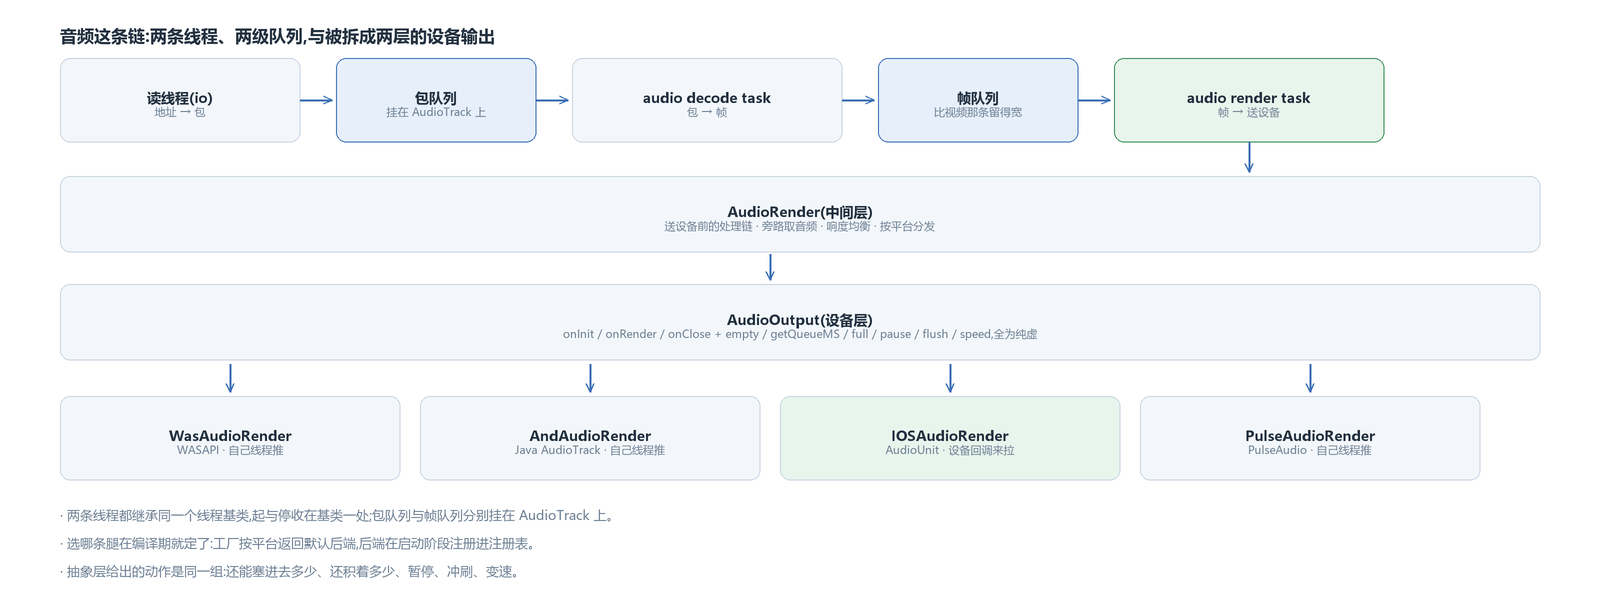
音频轨自己带着两级队列和两条线程。包队列在前面,读线程解出来的包按轨落到这儿;audio decode task 从包队列取包、解码,把帧写进帧队列;audio render task 从帧队列取帧、送进设备。两条线程都继承同一个线程基类,怎么起、怎么停收在基类那一处。解码线程先起,等解码器把输出格式定下来,渲染线程才有条件建起来——设备要用什么格式开,得先知道。
帧队列的深度音频这条比视频宽。视频那边的顾虑是队列排太长时 GPU 资源可能先被收走;音频这边怕的是断,声音断一下耳朵立刻能听出来,所以宁可多占一点内存。
包队列满了就把压力往回顶到读线程,这一层音频与视频共用同一套机制。
音频渲染的两层:AudioRender 与 AudioOutput
音频渲染在代码里分了上下两层。上面那层是 AudioRender,上层直接持它:送设备之前的处理链(回声消除这类音频前后处理)、旁路取音频、响度均衡都收在这一层,处理完再往下分发。下面那层是 AudioOutput,设备专属的东西在这里定成纯虚方法——onInit / onRender / onClose 三个生命周期钩子,加上 empty / getQueueMS / full / pause / flush / speed 一组队列与时钟控制。
四条平台实现各自把这些方法填完:Windows 一条走 WASAPI,Android 一条走 Java 层的 AudioTrack,Apple 一条走 CoreAudio 的 AudioUnit,再加一条 PulseAudio 给 Linux。选哪条在编译期就定了:工厂取默认音频输出时按平台返回后端类型,这些后端在启动阶段注册进注册表,工厂照着类型取。
分出这一层的用处,是上面那层不必知道底下是哪种设备在接数据。
交数据:自己推与等设备来拉两种
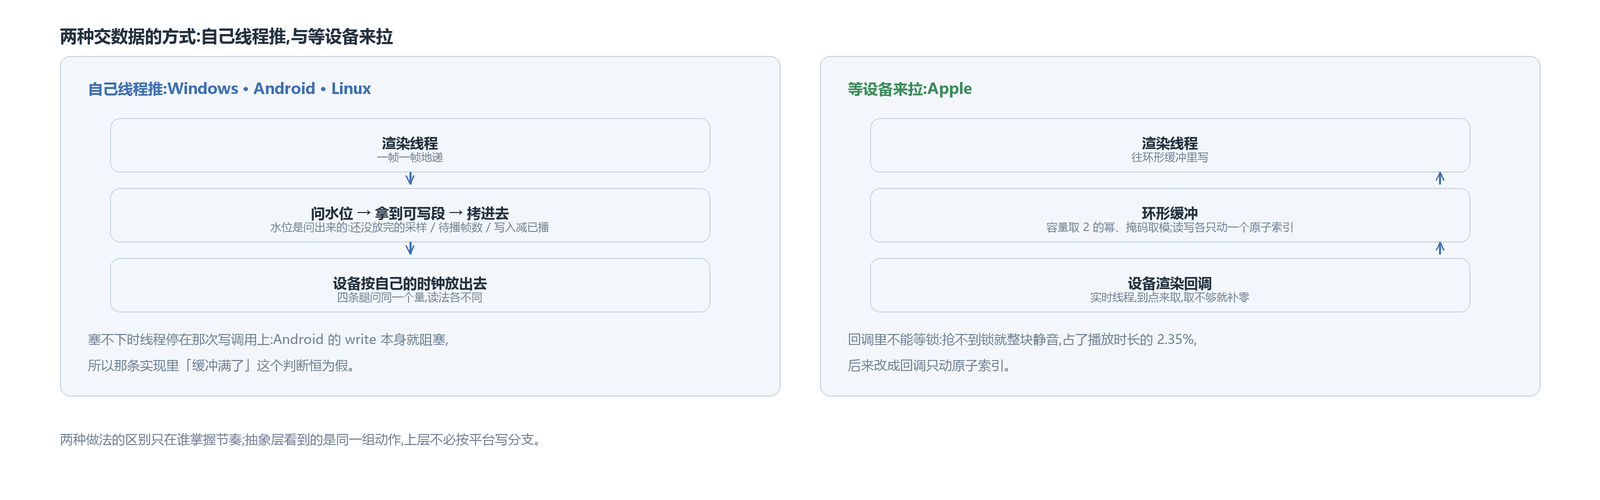
四条实现里,三条是「自己一条线程往里推」。
Windows 这条先跟设备要一块比默认宽得多的缓冲——按一帧长度的好几倍要,系统默认那档太窄。之后每一帧都是同一个套路:问缓冲里还积着多少采样、拿到可写的那一段、把数据拷进去、再放行。设备要是被换了(用户插耳机、改默认输出),这条腿会收到通知,把设备整个重建一遍。
Android 交的是 Java 层的 AudioTrack,缓冲在系统推荐值上再放宽一些,用流式模式写。写这个动作本身就是阻塞的,所以这一条实现里「缓冲满了」的判断恒为假:塞不下的时候,线程自己停在这次写调用里。
Linux 那条是 PulseAudio,缓冲也按一帧长度的几倍要,写用一个相对定位的接口推。
Apple 这条反过来:它不推,给 AudioUnit 注册一个渲染回调,设备到点来拉。回调跑在实时线程上,不能等锁,所以这条腿自己先建一段环形缓冲(容量取 2 的幂,取模用掩码),渲染线程往环里写,回调从环里取,取不够就补零。历史上这个回调里用过互斥量,抢不到锁就整块静音,占了播放时长的百分之二点三五,这也是那时候声音听着断续的直接来源;后来改成回调里只动原子索引。
两种做法落到抽象层是同一组动作:「现在还塞得进去吗」「还积着多少」。推的那三条把线程阻塞当成背压,拉的那一条把环形缓冲当成背压,上层看到的东西一样。
设备的选取与失效处理
设备这一层还剩两件事,拿 Windows 那条实现说最清楚。
一件是选哪台设备。这条实现不维护设备列表,直接要系统的默认播放端点;打开时用共享模式,不用独占——独占要求格式与设备完全对得上,系统一改配置就开不了。
另一件是设备失效之后怎么回来。写数据失败、查水位失败,都按设备失效处理:标一个重建,退回重试,重试之间留一段退避,免得设备全被拔光之后还在空转;暂停期间重建,建完保持暂停,不自己开始放。收到的设备通知只认「默认播放设备变了」这一种,端口层面的拔插交给失效那条路兜。
这里有一个实测出来的教训:缓冲被抽干就是爆音。判「还能不能再塞」的水位原来按两段音频的长度算,而渲染线程那一侧有几十毫秒的抖动,余量会被它吃掉,于是水位提到不低于半个设备缓冲。这条实现也没有原生的「清空」动作,清缓冲只能停再开。
交给设备之前的格式、重采样与音量
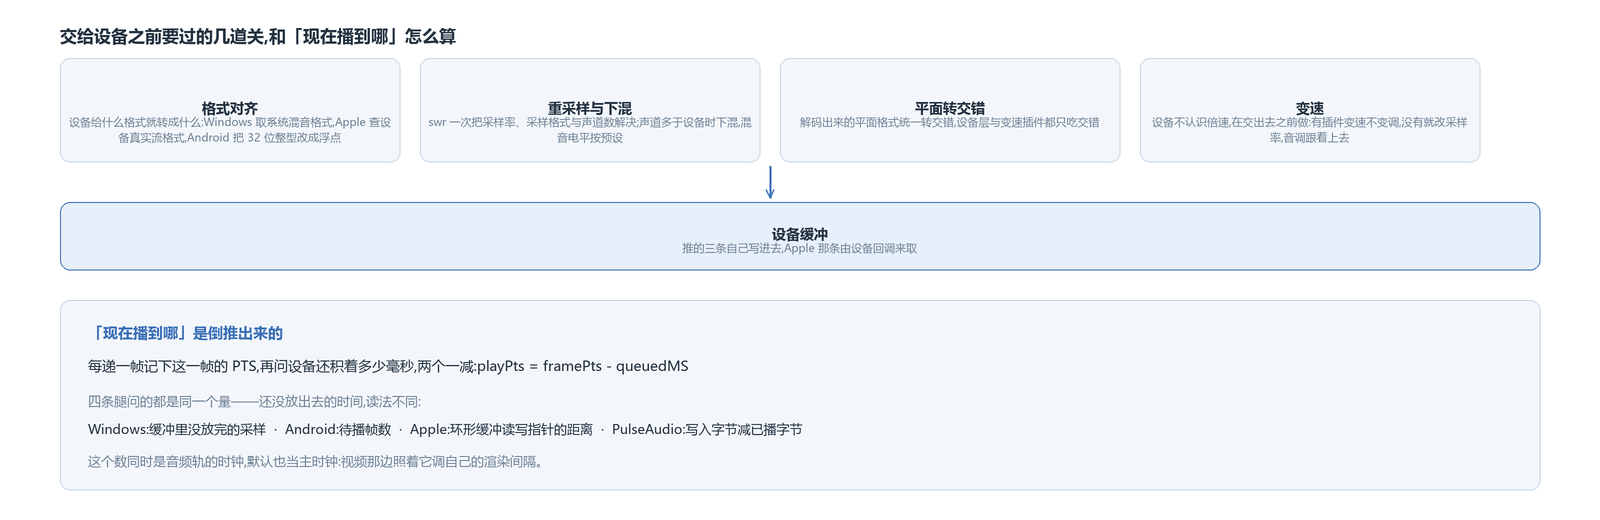
设备要的格式通常不是流里的格式。Windows 上打开设备时拿到的是系统混音格式,Apple 上要反过来查设备真实的流格式,Android 这条恒把 32 位整型的位型当浮点读——所以引擎侧得先把 32 位整型改成浮点,不改的话整轨都是噪声。两边对不上就在链上重采样一次:采样率、采样格式、声道数一次解决;声道多于设备时一并下混,混音电平按预设参数给。
Android 上还有一条降级:多声道轨建不出来就降到两声道。不降的话这条轨没人消费,帧队列涨满会把整条播放管线堵死。
解码那边也要配合:平面格式统一转成交错再往上走,设备层和变速插件都只吃交错。
音量也落在这一层。Windows 与 PulseAudio 是在软件里逐采样乘;iOS 交给 AudioUnit 的输出音量参数,Android 交给 AudioTrack 的立体声音量。播放器侧另外还有响度均衡,按 BS.1770 计量响度,再慢收敛地调增益。
变速在交给设备之前完成
设备本身不认识倍速:四条实现里的 speed 都是空实现。所以倍速在把数据交出去之前完成,手段看有没有插件。有变速插件就走它,变速不变调;没有插件就降级成改采样率——采样率按倍速除一下,同一段数据放得更快,音调跟着上去。
倍速超过四倍、低于零点二倍,或者开了只解 I 帧的模式,音频这一路不再出声:帧照样从队列出,时钟照样推进,就是不渲染。
现在播到哪:从队列积压倒推
设备不报「播到第几毫秒」这个数。引擎的算法很短:每递一帧记下这一帧的 PTS,再问设备还积着多少毫秒,两个一减就是当下播到的位置。
「还积着多少」这四条腿各有各的算法:Windows 数缓冲里还没放完的采样,Android 数待播帧数,Apple 用环形缓冲读写指针的距离,PulseAudio 用写入字节减已播字节。算法不同,算出来的是同一个量:还没放出去的时间。
这个数就是音频轨的时钟。默认也拿它当主时钟,视频那边照着它调自己的渲染间隔;主次怎么定、偏差大了往哪边纠,是下一篇的事。
引擎 avox 在 GitHub 开源:github.com/xxxzhou/avox,音频这条链、设备层和四条平台实现都在里面。
音视频开发 播放器 C++ Android 音频