编码器注册:同一张注册表,Android 自己的实现
编码器按编码类型各注册一个,标成硬件。选型、候选链与「只在首帧前换道」这套规矩在讲录制链的那一篇写过,这里只说这个实现内部。
建的时候按编码选平台的 MIME 串,再按类型建编码器;配置那一段配了这么几样:宽高、码率、帧率、关键帧间隔、档次、以及禁用 B 帧。码率不用手工给——上层不设的时候按分辨率、帧率与几个系数算一个,再限幅。
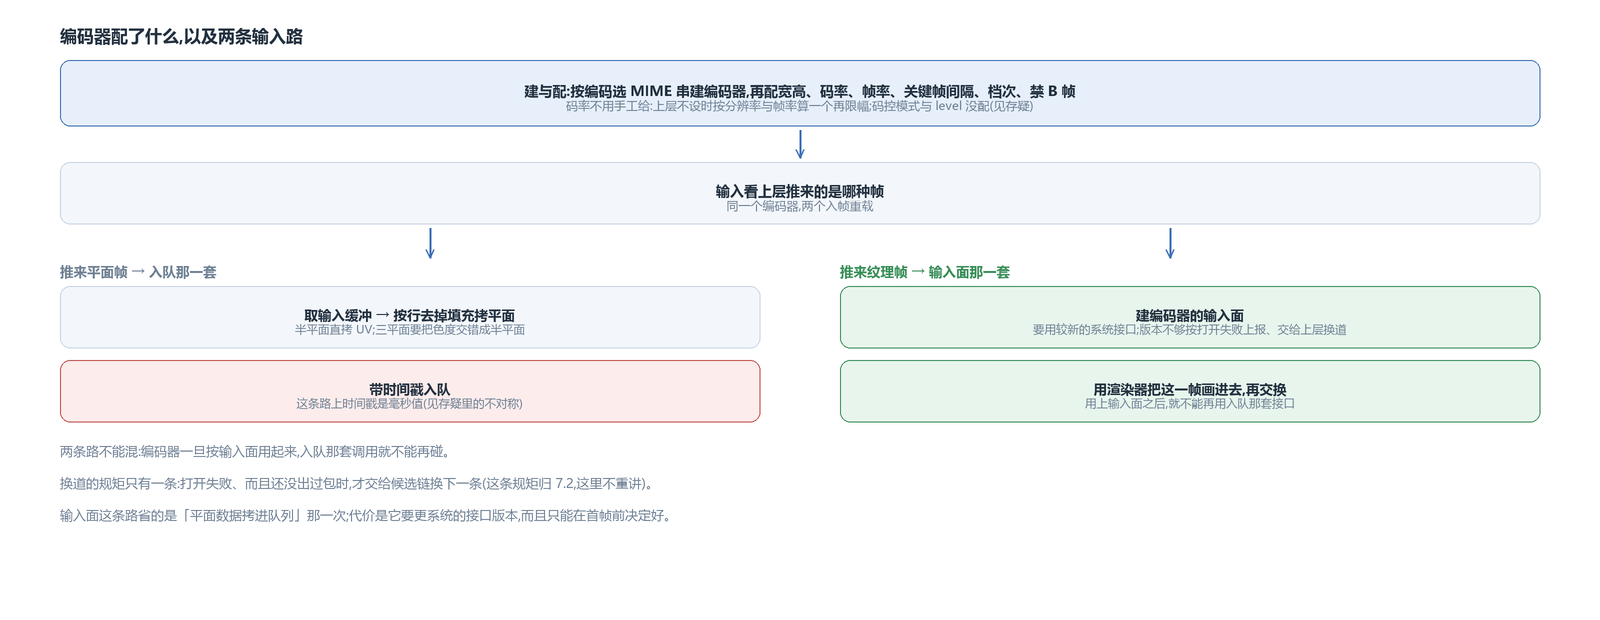
有一处没配:码控模式。没有设恒定码率或质量档那一类键,码率给的是个平均目标。另一处是档次只设了 profile 没设 level。
两条输入路,看上层推来的是哪种帧
这个实现有两个入帧重载,对应两种帧:
推来的是平面帧时,走入队这一套:取一个输入缓冲,按行把填充去掉再拷平面——半平面的那一档直接拷 UV 面,三平面那一档要把两个色度面交错成半平面,再带着时间戳入队。
推来的是纹理帧时,走输入面这一套:先建编码器的输入面,再用一个自己的 EGL 渲染器把这一帧画进去,然后交换。这条路一旦用上,就不能再用入队那套接口。
输入面要用较新的系统接口,版本不够时直接按打开失败上报,交给上层换下一条候选。
画进去那一步
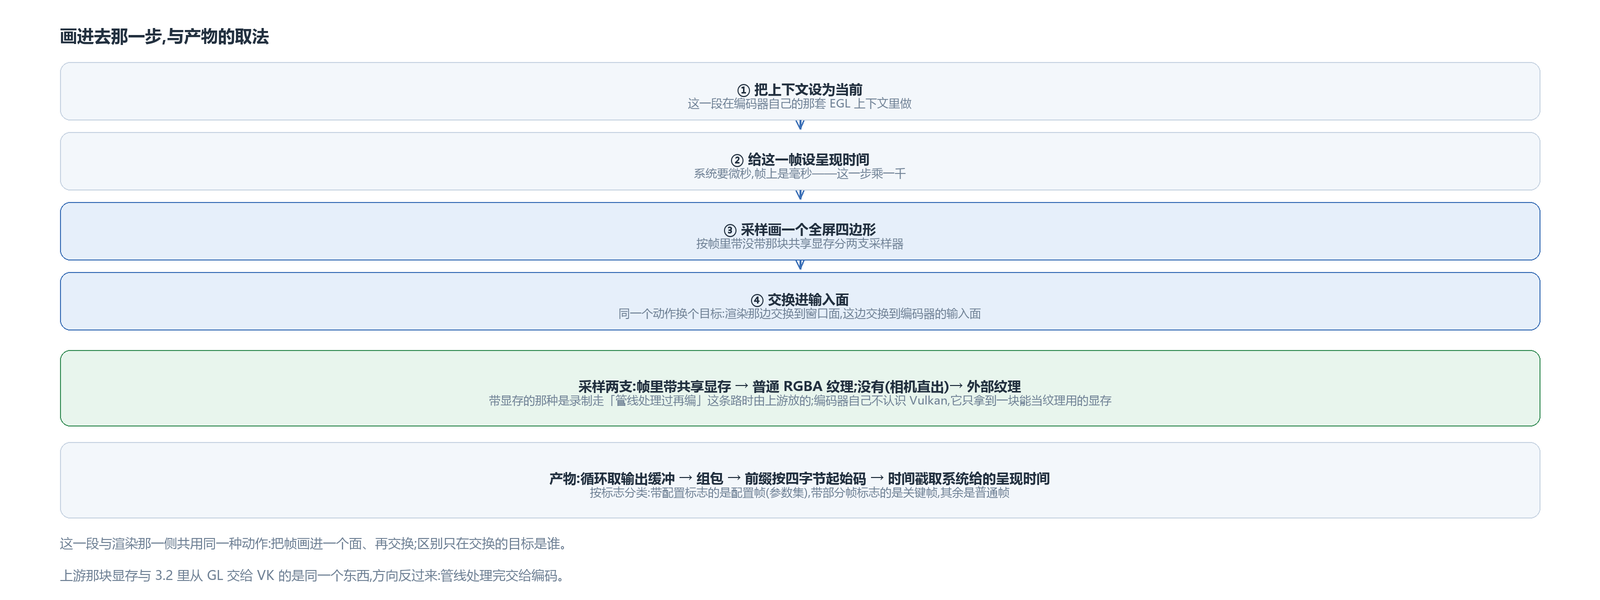
渲染器每次要做三件事:把上下文设为当前,给这一帧设一个呈现时间(系统要的是微秒,而帧上的时间戳是毫秒,这一步要乘一千),然后采样并画一个全屏四边形,最后交换进输入面。
采样按帧里带没带那块共享显存分两支:
录制走的是「管线处理过再编」这条路时,帧里带的是管线交出的那块显存,采样用普通的 RGBA 纹理;相机直出那种帧没有这块显存,采样用外部纹理,和渲染那一侧的做法一样。
也就是说,编码器前面这一段与渲染那一侧共用同一种动作:把帧画进一个面,再交换。区别只在交换的目标——渲染那边是窗口面,这边是编码器的输入面。
帧里那块显存:上游管线交出的输出面
编码器自己不认识 Vulkan。帧里那块显存是上游放的:录制时如果输出不是 CPU 帧,管线会把它的输出面交出来,帧对象里带的就是那块共享缓冲(渲染那一侧从 GL 交给 VK 的同一个东西,只是方向反过来)。编码这一侧拿到的只是「一块能当纹理用的显存」这个事实。
码率的算法:像素数乘帧率乘两个系数,再限幅
上层不设码率时,这个实现按分辨率与帧率算一个:像素数乘帧率,再乘两个系数——一个是内容的复杂度因子,一个是编码器自己的因子,最后限幅到一个区间里。
这几个系数是经验值,量级上够用就行,不追求把某一段画面压到刚好。真要控某一部片子的体积,得在上层把码率显式设进来——这一版没有做按画面内容动态调整的那一层。
输入面那条路上,上下文与「交换」的含义
这条路的渲染器要借上游的上下文:因为采样的对象是那一帧里的纹理,而纹理的所属关系在上游那套上下文里。这一步插进已有的渲染栈,不另起一套。
「交换」在这个场景里的意思也变了:目标是把这一帧交给编码器,不上屏。系统调用这一下之后,编码器就拿到了这一帧的数据,不需要、也不能再走入队那套接口。
取产物那一侧带一个等待超时:没有包就等一小会儿再看,避免空转把线程占满。
与解码侧共用的纹理包装与共享显存
同一个纹理包装类两边都在用:解码侧用它承接解码器的输出面,编码侧用它当输入面的来源——一边是「从它取帧」,一边是「往它送帧」。
共享显存那套设施也是共用的:解码与渲染之间的那块缓冲,和编码输入的那块是同一种东西,只是方向不同。相机直出那种帧没有这块缓冲,走的是外部纹理那一条,采集那边交出来的就是它。
产物与时间戳
出包这一段:循环取输出缓冲,组一个码流包,前缀按四字节起始码算,时间戳用系统给的呈现时间同时当解码时间戳;按标志位分类——带配置标志的算配置帧(参数集),带部分帧标志的算关键帧,其余是普通帧。
时间戳这里有一处不对称:CPU 那条路把帧上的毫秒值原样当微秒入队,GPU 那条路在渲染器里乘了一千。两条路的单位取法不同。
前缀那个「四字节」也不是随手定的:这一类编码器交出来的码流是长度前缀形式,所以这一层在包上记下前缀长度,往下封装那边按这个长度去切起始码。如果这里记错,封装那边会把包切在错误的边界上。
流开头的那几包都是配置帧。所以分类不是「关键帧 / 非关键帧」两档,而是三档:配置帧、关键帧、普通帧。
编码器自己建、码率自己算、输入看帧的类型走两条路之一、产物带起始码前缀回上层。与解码那一侧共用的是那个自研的纹理包装与那块共享显存——硬解接入与硬解帧去处那两篇写过,这一篇不重讲。
引擎 avox 在 GitHub 开源:github.com/xxxzhou/avox,输入面那条路与那块共享显存都在里面。
音视频开发 播放器 硬件编码 MediaCodec OpenGL ES Android