回声、噪音、增益各归各的算法
录屏和录音一开始只有采集和编码两段,推出去一听就不对:有回声、有环境噪音,音量还忽大忽小。三件事各对应一个算法。回声是扬声器放出来的声音绕一圈又被麦克风采了回去,处理它靠回声消除(AEC);环境噪音交给降噪(NS)压;音量忽大忽小归自动增益(AGC)管。三项合称 3A,各是独立的开关,可以只开其中一两项。
WebRTC 的这套处理一直在跟着它的通话场景迭代,自己重新写一遍不现实。要操心的只有两件事:喂给它的数据得先归一成它要的样子;处理链得放在录音链路里正确的位置上。
进处理之前,先把数据归一
设备采上来的 PCM 什么样都有,进处理前按几条规则归一。
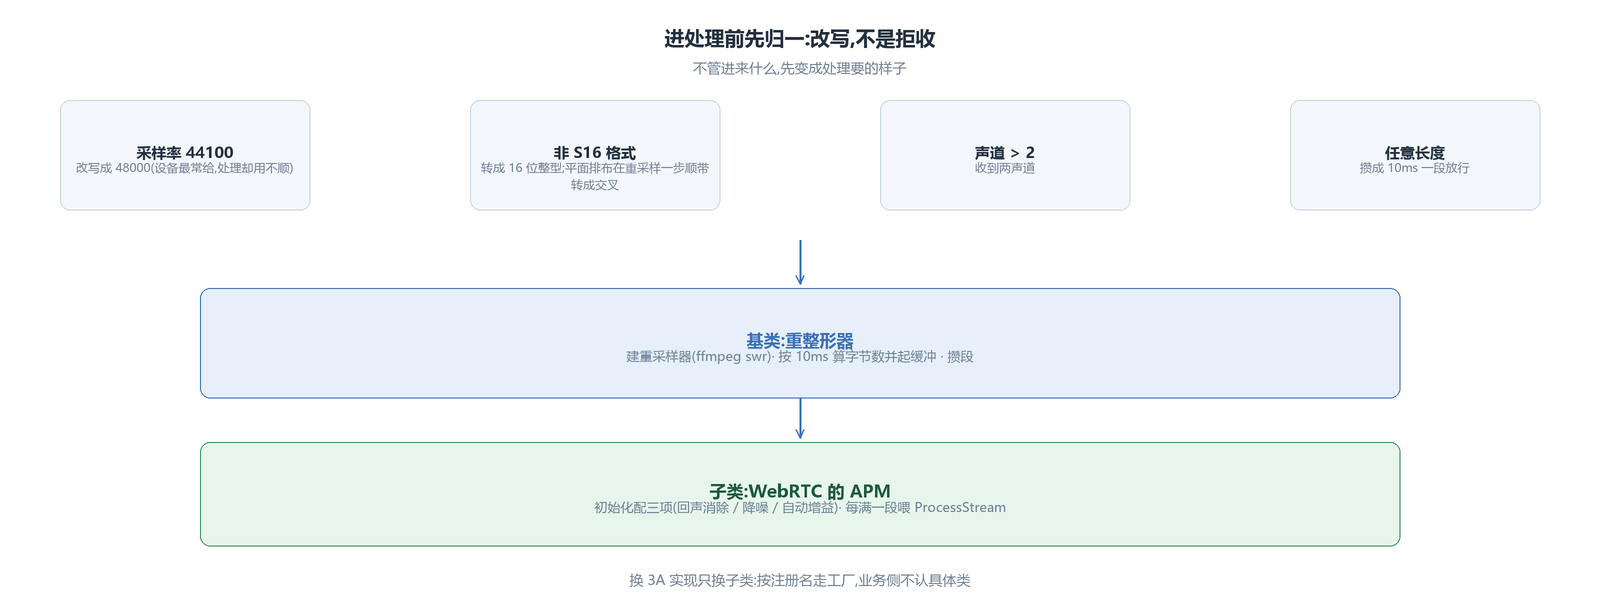
采样率是第一项。44100 这个设备给得最多的值,APM 用起来反而不顺,遇到 44100 直接改写成 48000;32000、48000 本身没问题。格式是第二项:处理按 16 位整型做,进来的不是 S16 就转成 S16。声道是第三项:超过两声道的收到两声道。这三条都是改写规则,不是拒收——不管进来什么,先归一成处理要的样子。
平面排布的数据不用单独操心:重采样那一步走 ffmpeg 的 swr,平面格式在转换那一步就成了交叉排布。要留神的是 swr_convert 的指针,平面格式的输入输出得指向各个平面的数组,双声道就是两个指针,指错位置出来的就是坏声音。
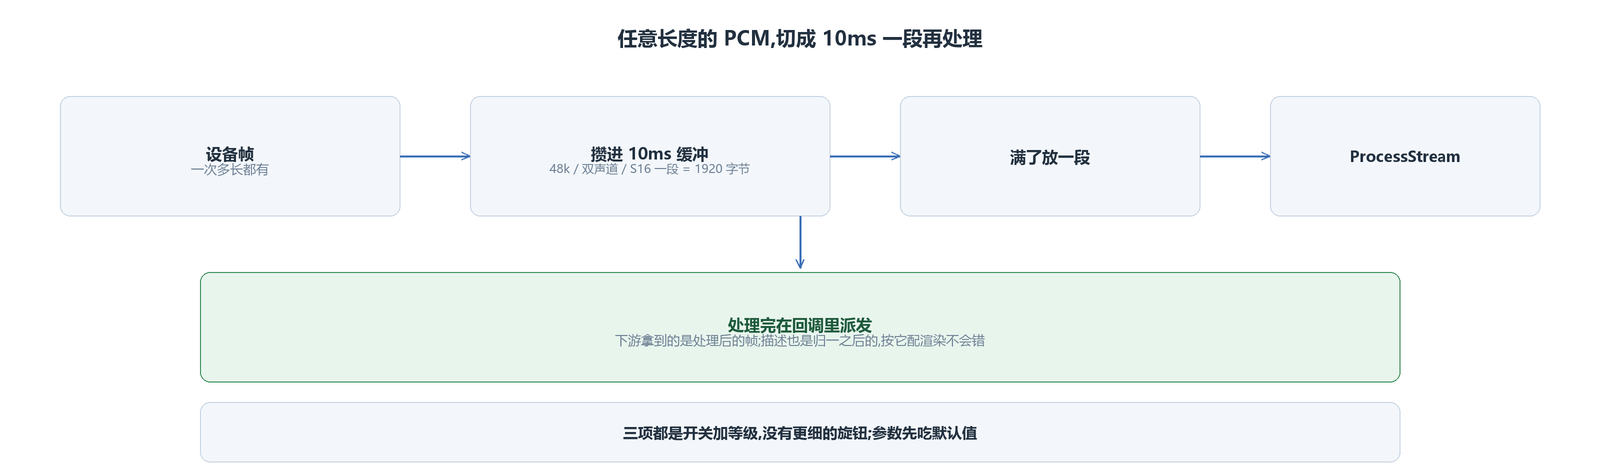
最后一项是长度。APM 按固定时长处理,一次收 10ms。设备给的一帧多长都有,所以还要有一层把任意长度的 PCM 攒起来,凑满一段放行一段。
重采样与分段沉到基类,算法放子类
归一和切段是任何一套 3A 都要做的,跟具体用谁的算法无关,所以这两件事沉在基类里:基类同时是一个重整形器,初始化时按输入输出格式建重采样器、算好 10ms 对应多少字节、起一块 10ms 的缓冲。归一改写的不只是处理时用的格式,描述本身也会被更新后交回给调用方——下游拿到的描述就是处理链输出的格式,按它配渲染不会错。
真正调 APM 的活在一个子类里,它只做两件事:初始化时把 APM 配好;缓冲攒满一段时把这段喂进去。这样分层之后,想换一套别的 3A 实现,只换子类;归一、重采样、分段一概不动。子类也不直接构造,走一个按名字建实现的工厂,注册名就叫 webrtc,业务侧只管要一个「处理链」。
10ms 有多大,可以算一笔账:48000 赫兹、双声道、16 位整型,10ms 就是 480 个采样点、两路各 480 份、每份两个字节——1920 字节。缓冲就按这个量起,设备给来的数据不管多长,攒够这一份就放行一份。
三项的配置:回声消除、降噪、自动增益
子类初始化时先跑一遍上面的归一,然后往配置里填三项:回声消除打开,移动模式不开——那套是为移动端降配用的;降噪打开,等级取高;自动增益用的是新接口那一路。三个开关默认全开。填完用内置处理的构造器建出 APM 实例,再按输入流、输出流两个配置初始化。
每段攒满就调 ProcessStream:输入是攒好的这段,输出写到另一块缓冲,处理完在回调里把帧派发出去。三项都是开关加等级,没有更细的旋钮;算法参数没有细调,先吃默认值,效果要再磨是后面的事。
接在音频源与渲染两处
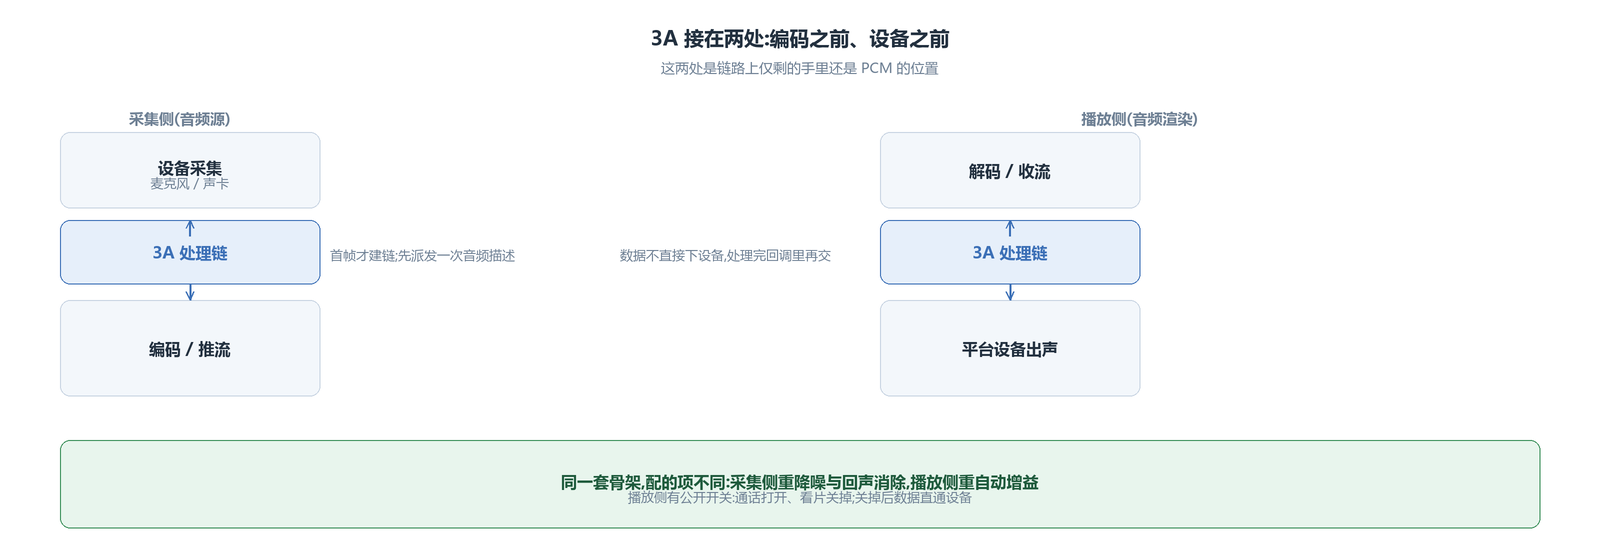
3A 要接的地方有两处,业务上分得清楚。位置上也有讲究:两处都在编码之前、解码之后——3A 吃的是波形,编码一旦完成,数据成了压缩域的包,算法就没有下嘴的地方了;所以采集侧放在数据交给编码器之前,播放侧放在数据交给设备之前,这两处是链路上仅剩的、手里还是完整 PCM 的位置。音频源是采集侧,录屏、录音、通话的对端都从这走,最要的是降噪和回声消除;音频渲染是播放侧,最要的是自动增益。
音频源的做法:第一帧进来才动手,按设备实际给的格式把处理链建起来,建好后先派发一次音频描述(采样率、声道这些,下游按它配渲染),之后的每一帧先交给处理链,处理完的回调再把帧往外派。链没建好或者没开处理的分支上,帧原样直通。
音频渲染同理:描述设定时把处理链建好,要发的数据不直接下设备,先过一道处理,从回调里回来再交给平台设备。两处的差别只在配了哪几项,骨架是同一个。
开关也在两处各管各的。渲染侧留了公开的开关:做通话就打开,看片就关掉,关掉之后数据直通设备,一趟处理都不走——看片这条路不需要消除回声,让数据少过一道手。没开处理的时候,音频源那条腿同样是直通分支,帧原样往外派,只是不建链、不占那 10ms 的缓冲。
到这儿,录音链上的 3A 就算接完了。下一篇换到拉流那头:WebRTC 自己不带 H265 和 AAC 的解码,怎么用它的工厂跑自己的解码器。
引擎 avox 在 GitHub 开源:github.com/xxxzhou/avox,基类、子类与两个接入点都在里面。
音视频开发 音频处理 WebRTC 回声消除 降噪 自动增益 C++