硬解留给平台的两处:解码设备与出帧
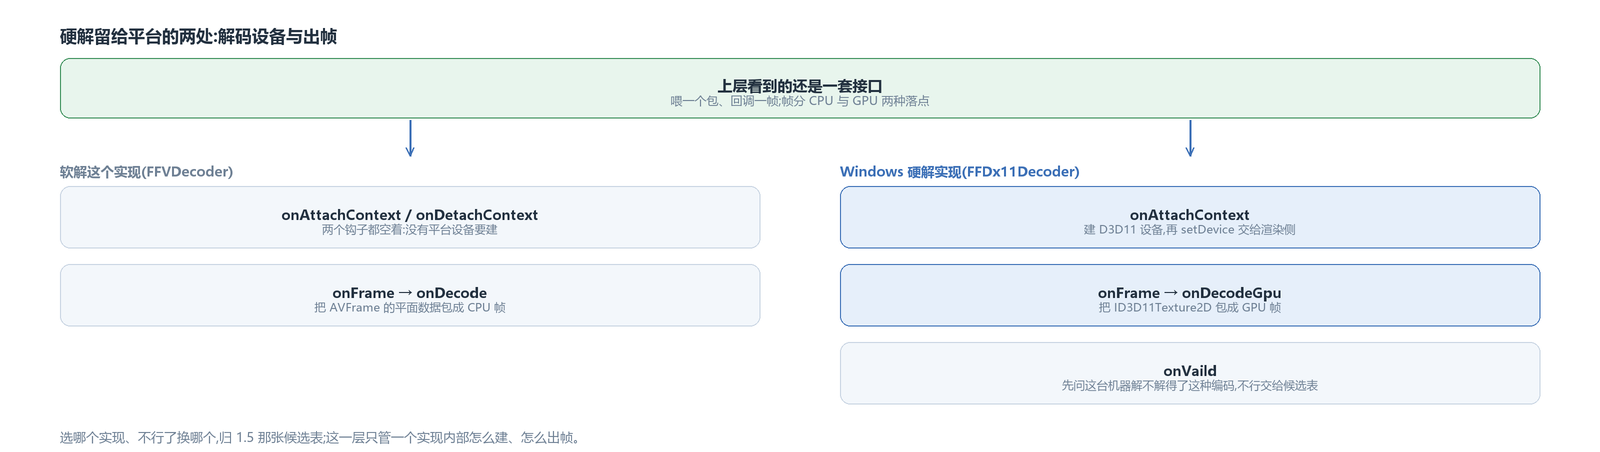
解码那条线的接口前面讲完了:上层喂包、回调帧,帧有 CPU 与 GPU 两种落点。硬解不开新线,它把同一条线的出口换一种产物。所以要平台填的地方也少,就两处。
一处是设备。FFmpeg 那条解码链开始配解码器之前会调一个钩子 onAttachContext,收摊时对着的是 onDetachContext。软解这两个钩子里什么都不做;平台硬解在这里把解码要用的设备建起来,平台差异就是从这一处进来的。
另一处是出帧那一下。基类的 onFrame 交给实现覆写:软解把 AVFrame 里的平面数据包成 CPU 帧,硬解把解码器给的原生纹理包成 GPU 帧,再从 onDecodeGpu 这个回调派发出去。派发之后,帧和软解那条路进的是同一个帧队列、同一套背压。
上层两处都不碰,它看到的仍然只是「一帧」。哪个实现不行了该换哪个,是解码接入那一篇那张候选表管的事,这一篇只写一个实现内部怎么建、怎么出帧。
Windows 硬解实现:解码器、设备上下文与注册名
Windows 的硬解实现是 FFDx11Decoder,同时继承两样东西:FFmpeg 侧的软硬共用基类 FFVDecoder,和渲染侧认的设备上下文接口 Dx11Context。
第二个继承是这条路的关键。硬解帧要连同「哪台设备、哪张纹理」一起交给渲染,而渲染侧取这两样东西,要的就是设备上下文这个接口。解码器自己就是那个提供者,于是它直接继承这个接口。这也意味着帧从解码器到渲染之间没有一次内存往返,也没有一次跨设备的句柄转换,两边用的是同一台 D3D11 设备。
它注册进解码器表的名字是 ff_h264_dx11、ff_hevc_dx11、ff_vp9_dx11、ff_av1_dx11,都带硬解标记(命名规则见解码接入那一篇)。注册只发生在 Windows、且这一版构建编了 FFmpeg 的时候。
硬解实现的两种来路:自研与借 FFmpeg
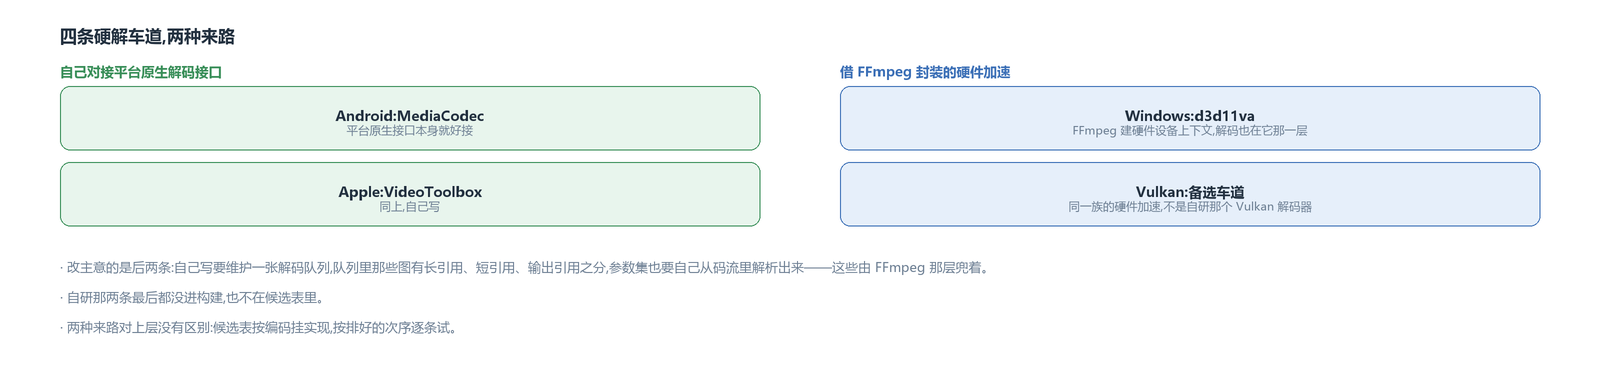
这四条硬解车道不是一种做法:安卓与苹果自己对接平台的原生解码接口(MediaCodec、VideoToolbox),这两套接口本身就好接;Windows 这条和 Vulkan 那条备选,我原本也想自己写,评估下来借了 FFmpeg 封好的硬件加速。挑这两个方向还因为:各家显卡厂商的方案只覆盖自家硬件,DX11 与 Vulkan 才通用。
放弃自己写,两条车道是同一个原因:硬解解码器要管的比「调一个接口」多得多。它内部得维护一张解码队列,队列里那些图有长引用、短引用、输出引用之分,什么时候能回收由这些引用决定;参数集也得自己从码流里解析出来填进解码配置。这些活 FFmpeg 那一层都在做:参数集解析、图的引用换算、纹理池。
自研那两条最后都搁下了,没进这一版构建(src/avox_windows/dx11/Dx11VDecoder.hpp、src/avox_vulkan/decode/)。对上层,两种来路没有区别——候选表按编码挂实现,按排好的次序逐条试(归解码接入那一篇)。
设备由 FFmpeg 建,建完交给渲染侧复用
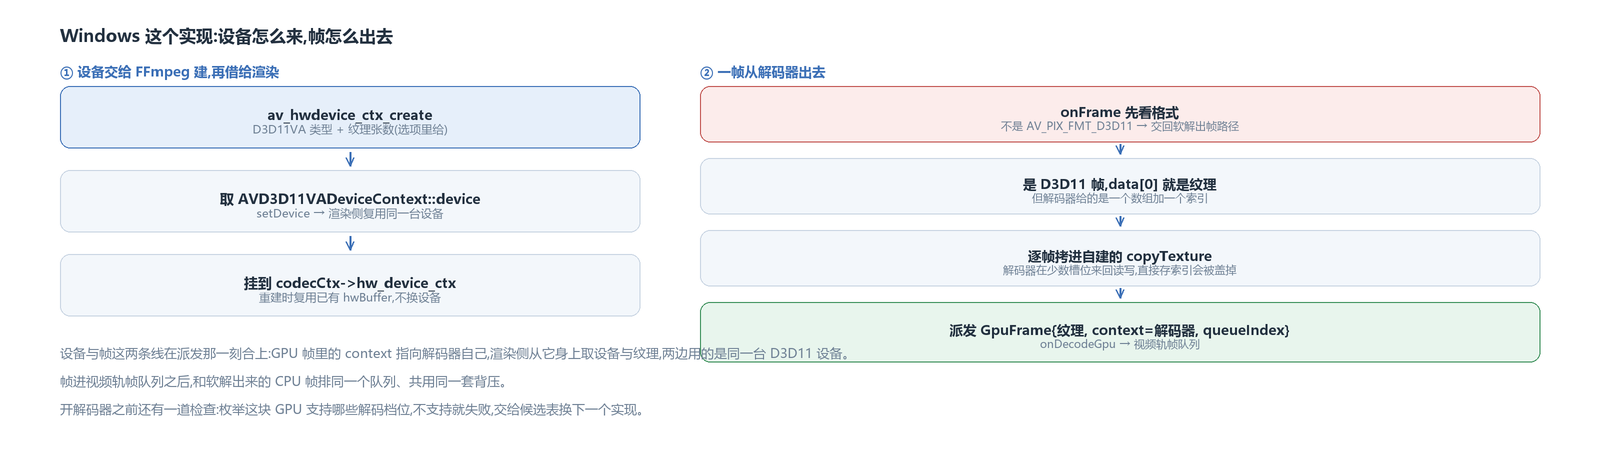
设备不是我拿 D3D11CreateDevice 建的。这个实现借 FFmpeg 的 d3d11va:调 av_hwdevice_ctx_create 要一个 D3D11VA 类型的硬件设备上下文,可以过两个选项进去——给解码器留多少张输出纹理、Debug 构建里打开 hwcontext 的调试层。
上下文建好之后,把里面那台 ID3D11Device 取出来,调 setDevice 交给渲染侧。渲染侧随后建纹理、建着色器都用这一台。
接着把这个上下文挂到解码器上(hw_device_ctx)。挂上去之后,输出纹理池由 hwcontext 按前面给的张数自己派生,我没有自己建 AVHWFramesContext;输出像素格式也不用挑,d3d11va 这一侧由 FFmpeg 的硬件加速自己协商——Vulkan 那个实现才需要在 get_format 里显式指定。
seek 和换配置会让解码器整体重建,但设备不能在重建里跟着换一台。重建时走的是复用那一支:已经有 hwBuffer 就直接引用一次挂上去。这里图的不只是省时间——渲染侧在设备上已经建过自己的资源,重建设备会让解码和渲染各自拿着一台,前面「同一台设备」的省事全部作废。放掉引用在收摊那个钩子里做。
硬解帧的产物:一张纹理加一个索引
onFrame 拿到的第一件事是看格式。不是 AV_PIX_FMT_D3D11,说明这一帧其实没走上硬解,直接交回基类的软解出帧路径。这条退路很便宜,挡的是「以为在硬解、其实解码器回了软解」那种情况。
是硬解帧,data[0] 就是一张 ID3D11Texture2D。但拿到句柄还不能直接派发,这里有一个必须绕开的坑:解码器给的是一组纹理加一个索引,并且它在少数几个槽位之间来回读写。外面若只记下那个索引,等消费端真去取图时,那片显存可能已经被下一帧盖了。
所以这个实现自己建一张纹理,每帧把那一张拷进自己这张,再把自己这张和顺序递增的索引一起派发出去。尺寸变了就重新建这张拷贝目标。
派发的结构是 GPU 帧:纹理指针、格式与宽高、时间戳,加上 context 指向解码器自己(渲染侧从它身上取设备)、queueIndex 标明这是自建数组里的第几个。帧进视频轨的帧队列,和软解出来的 CPU 帧排在同一个队列里。
入队这一下还有一层包装:队列里存的是一个带缓冲对象的帧,缓冲类型标明这是哪一家的纹理(Windows 上是 dx11,Android 是 opengles,Apple 是 metal)。少了这个类型,下游拿到那个指针只能靠上下文猜它是内存还是纹理;有了它,渲染和录制各自按类型决定怎么对待这一帧。软解切硬解、硬解切软解时,这一层的类型会跟着换,帧对象本身可以复用(缓冲类型与帧的复用见帧源那一篇)。
尺寸变化与初次赋值的判据
解码线程每次收到配置包都会往解码器推一次,推完要判断宽高有没有变,变了就走尺寸变化那条支路。这里有一个必须挡住的误判:尺寸第一次从零变成一个有效值,那是初始赋值,不是换尺寸。
挡不住的代价不小。尺寸变化在硬解这个实现里会触发整条重置——解码器重建、包队列清空。本地文件的包在起播时已经全量入队,队列被清掉之后没人再往里送,解码器就在那儿等着,屏幕上零帧。我是在一个重复播报参数集的 HDR 片源上撞到的:同一组 SPS/PPS 反复喂进来,宽高两次都报同样的值,却有一侧先到、一侧后到,判断就成了「变过」。
判据本身很简单:老尺寸得是有效值,才允许判变化。
硬解帧缺的 HDR 与杜比视界元数据
硬解帧从解码器出来时,帧上只带图像本身。HDR 的静态元数据与杜比视界的整形数据这两样,FFmpeg 在硬解这一侧不会挂到帧上,软解那条路才有。可上游要的是「播放时按这批参数做色调映射」,缺了就是画面泛白或者一片死黑。
补的办法不是在帧上找,而是绕开解码器:喂包之前用一个旁路扫描器把原始码流扫一遍,SEI 里那几段静态元数据、杜比视界的整形单元都在这里读出来,值变了才往上报,报的就是解码接入那一篇里那两条元数据回调。放在格式转换之前做,因为转换之后包已经不是原样,扫出来的东西就不可信了。
元数据拿到之后怎么用,不在这一篇里——那是 HDR 那一章的事。
开解码器前先探测这块 GPU 的解码档位
这道检查里,VP9 与 AV1 尤其要看驱动:得枚举一遍这块设备支持的解码档位,不支持就直接失败,让候选表换下一个实现去试,不去猜。
档位的 GUID 在这个实现里是写死的常量。它们在 dxva 头里是宏,直接引用那个宏在链接期找不到符号,只能自己抄一份。这活不好看,但省不了。
到这里 Windows 这个实现通了:设备、解码器、纹理数组、GPU 帧,一路到帧队列。帧接下来去哪是下一篇的事——它有两个去处,一个进 Vulkan 管线做统一处理,一个直接贴到窗口上。
同一套抽象在 Android 与 Apple 上填的是另外两个洞:一边是 MediaCodec 与它那个 Surface,一边是 VideoToolbox 与 ObjC 的边界。骨架照这一篇的来。
引擎 avox 在 GitHub 开源:github.com/xxxzhou/avox,硬解这层抽象与这个 D3D11 实现都在里面。
音视频开发 播放器 硬件解码 D3D11 FFmpeg C++